


Cách gỡ lỗi API Node.js trong môi trường production
Bắt đầu bằng một dấu hiệu sự cố production có thể tái hiện
Gỡ lỗi trong môi trường production bắt đầu từ một dấu hiệu sự cố cụ thể, không phải phỏng đoán về việc hàm nào đang bị lỗi. Hãy ghi lại endpoint bị ảnh hưởng, phương thức HTTP, thời điểm bắt đầu gần đúng, mã trạng thái, độ trễ phản hồi, phiên bản triển khai và việc sự cố ảnh hưởng đến mọi người dùng hay chỉ một nhóm người dùng. Ví dụ: “POST /api/orders trả về 500 đối với khách hàng ở châu Âu sau bản phát hành 2025.03.18” hữu ích hơn nhiều so với “API không ổn định”.
Hãy so sánh request bị lỗi với một request thành công có đầu vào tương tự. Kiểm tra xem vấn đề có xảy ra nhất quán, không liên tục, chỉ liên quan đến một khu vực hay chỉ giới hạn ở một loại tài khoản cụ thể hay không. Một dòng thời gian sự cố ngắn giúp liên kết các dấu hiệu với những thay đổi như triển khai, migration cơ sở dữ liệu, cập nhật biến môi trường, lưu lượng tăng hoặc sự cố từ bên thứ ba. Những bằng chứng này thu hẹp phạm vi tìm kiếm trước khi bạn kiểm tra mã ứng dụng.
Sử dụng log có cấu trúc trong Node.js
Các thông báo console thuần văn bản rất khó tìm kiếm khi nhiều instance production cùng xử lý request. Hãy sử dụng log có cấu trúc với các trường như timestamp, level, service, environment, requestId, route, statusCode, durationMs và tên lỗi. Một logger như Pino có thể phát JSON một cách hiệu quả, cho phép nền tảng log lọc tất cả phản hồi 500 hoặc sắp xếp request theo độ trễ mà không cần tự phân tích từng câu.
Hãy đưa vào ngữ cảnh giúp giải thích nguyên nhân lỗi, nhưng không log mật khẩu, access token, đầy đủ thông tin thanh toán hoặc body request không được giới hạn. Với một lỗi đơn hàng, chỉ cần log orderId, customer segment, tên thao tác cơ sở dữ liệu và trạng thái dependency có thể là đủ. Hãy sử dụng level log nhất quán: info cho các sự kiện quan trọng trong vòng đời, warn cho các bất thường có thể phục hồi và error cho các lỗi cần điều tra. Luôn đưa stack của lỗi gốc vào log nội bộ, vì stack thường xác định chính xác dòng mã nguồn và đường đi của lời gọi hàm.
Truy vết một request xuyên suốt các service
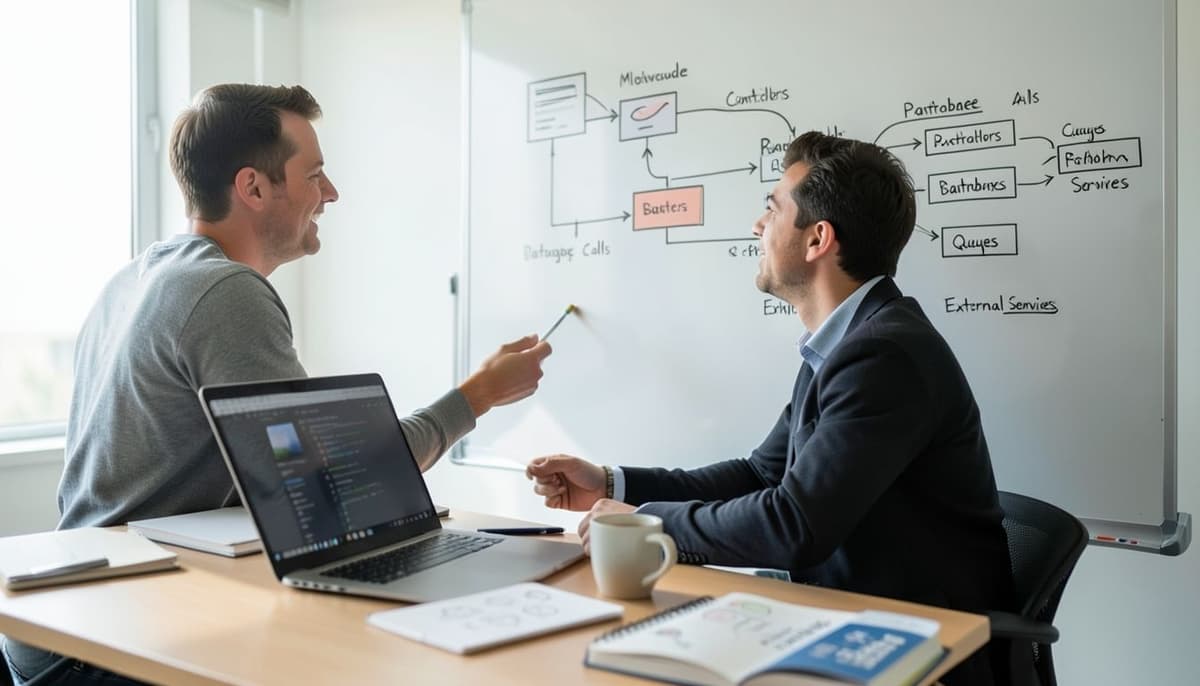
Request ID cho phép bạn theo dõi một thao tác qua middleware, controller, các lệnh gọi cơ sở dữ liệu, hàng đợi và các dịch vụ bên ngoài. Hãy tạo ID ở lớp biên nếu client không cung cấp, đính kèm ID vào header phản hồi khi phù hợp và truyền ID qua các lệnh gọi đến các hệ thống downstream. Trong ứng dụng Express, middleware xử lý request có thể đặt mã định danh trên đối tượng request hoặc trong một asynchronous context để các câu lệnh ghi log về sau sử dụng cùng một giá trị.
Đối với các hệ thống lớn hơn, hãy sử dụng distributed tracing với OpenTelemetry và truyền trace context qua các request HTTP. Một trace có thể cho thấy phản hồi API mất 900 mili giây, trong đó 40 mili giây được thực hiện trong Node.js, 700 mili giây chờ truy vấn cơ sở dữ liệu và 160 mili giây gọi dịch vụ đề xuất. Phân tích này giúp đội ngũ ứng dụng không tối ưu mã JavaScript khi độ trễ thực sự nằm ở một dependency. Hãy bảo đảm trace được lấy mẫu và loại bỏ dữ liệu nhạy cảm theo yêu cầu về quyền riêng tư và chi phí của bạn.
Kiểm tra lỗi mà không làm gián đoạn dịch vụ
Khi một lỗi được gửi đến hệ thống theo dõi lỗi, hãy kiểm tra đầy đủ stack trace, loại lỗi, ngữ cảnh request và mã định danh bản phát hành. Các lỗi như TypeError, lỗi phân tích cú pháp JSON, lỗi vi phạm ràng buộc cơ sở dữ liệu và ngoại lệ timeout dẫn đến những hướng điều tra khác nhau. Hãy nhóm các lỗi lặp lại theo stack trace đã được chuẩn hóa thay vì theo dữ liệu request duy nhất; nếu không, một lỗi có thể xuất hiện thành hàng nghìn vấn đề không liên quan.
Tránh gắn trình gỡ lỗi trực tiếp vào một tiến trình production đang bận, trừ khi nền tảng của bạn hỗ trợ việc gỡ lỗi có kiểm soát với overhead thấp. Breakpoint có thể tạm dừng công việc của event loop và làm tăng độ trễ đối với những người dùng không liên quan. Hãy ưu tiên các phương thức chẩn đoán an toàn như stack trace, heap snapshot được thu thập thông qua quy trình đã được phê duyệt, CPU profile và việc ghi log debug tạm thời với thời điểm hết hạn được xác định rõ. Nếu bắt buộc phải bật thêm log, hãy bảo vệ chúng bằng cấu hình, giới hạn phạm vi áp dụng và ghi lại chính xác thời điểm tắt thiết lập đó.
Kiểm tra event loop và tình trạng tài nguyên
Node.js có thể xử lý nhiều request đồng thời, nhưng các tác vụ JavaScript chặn event loop sẽ trì hoãn mọi request do tiến trình đó xử lý. Hãy tìm các thao tác tệp đồng bộ, việc xử lý JSON tốn nhiều tài nguyên, biểu thức chính quy lớn, thao tác chuyển đổi hình ảnh hoặc các vòng lặp trên những mảng lớn bất thường. Độ trễ event loop, mức sử dụng CPU, thời lượng request và các handle đang hoạt động khi được xem xét cùng nhau sẽ cung cấp bằng chứng tốt hơn chỉ số phần trăm CPU. Một tiến trình sử dụng CPU ở mức vừa phải vẫn có thể có thời gian phản hồi kém nếu các callback phải chờ phía sau một thao tác chặn.
Các vấn đề về bộ nhớ cần một cách tiếp cận khác. Hãy so sánh mức sử dụng heap sau khi garbage collection, resident set size, tần suất khởi động lại và số lượng kết nối đang hoạt động. Heap tăng đều có thể cho thấy các object bị giữ lại, cache không có giới hạn, các listener không bao giờ được gỡ bỏ hoặc dữ liệu request được lưu lâu hơn vòng đời của nó. Hãy xác nhận liệu mức tăng bộ nhớ là do ứng dụng hay dependency gây ra trước khi thay đổi giới hạn container. Giới hạn lớn hơn có thể trì hoãn lỗi hết bộ nhớ nhưng không loại bỏ được memory leak.
Xác thực cơ sở dữ liệu và các dependency bên ngoài
Nhiều sự cố API bắt nguồn từ bên ngoài route handler. Hãy kiểm tra mức sử dụng connection pool của cơ sở dữ liệu, thời lượng truy vấn, thời gian chờ khóa, các giao dịch thất bại, log truy vấn chậm và những thay đổi schema gần đây. Một pool bị cạn kiệt do các truy vấn chạy trong thời gian dài có thể khiến những request mới trông như bị treo và cuối cùng gây ra lỗi timeout. Khi có thể, hãy so sánh chính xác các tham số truy vấn và execution plan, đồng thời bảo vệ dữ liệu cá nhân hoặc dữ liệu mật trong đầu ra chẩn đoán.
Hãy coi các dịch vụ bên ngoài là những dependency có thể quan sát được, với timeout rõ ràng, giới hạn retry và cơ chế circuit breaker khi phù hợp. Retry không giới hạn có thể làm lưu lượng tăng gấp nhiều lần trong thời gian xảy ra sự cố và sử dụng hết mọi kết nối khả dụng. Hãy ghi log tên dependency, thao tác, giá trị timeout, số lần thử và danh mục lỗi phát sinh. Đối với một nhà cung cấp dịch vụ thanh toán trả về phản hồi 429, cách xử lý phù hợp có thể là backoff có kiểm soát và đưa thao tác vào queue, thay vì để mọi API worker liên tục gửi lại request ngay lập tức.
Áp dụng bản sửa lỗi an toàn và xác minh quá trình khôi phục
Hãy chọn hành động có thể hoàn tác nhỏ nhất mà bằng chứng cho thấy là phù hợp. Tùy vào nguyên nhân, hành động đó có thể là rollback một bản phát hành, vô hiệu hóa feature flag, sửa biến môi trường, chấm dứt một worker bị treo hoặc thêm rate limit tạm thời. Hãy lưu lại cấu trúc của request gây lỗi và các log liên quan trước khi thực hiện thay đổi, vì việc rollback có thể xóa mất bằng chứng cần thiết cho quá trình phân tích nguyên nhân gốc rễ sau này. Tuyệt đối không để người dùng chưa xác thực truy cập trực tiếp vào các endpoint chẩn đoán hoặc stack trace.
Quá trình xác minh nên sử dụng các tín hiệu từ môi trường production, thay vì chỉ dựa vào một request thủ công thành công. Hãy theo dõi tỷ lệ lỗi, độ trễ p95 hoặc p99, throughput, độ trễ event loop, bộ nhớ, lỗi dependency và các kết quả ở cấp độ kinh doanh như số đơn hàng hoàn tất. Sau khi áp dụng bản sửa lỗi, hãy kiểm thử cả trường hợp từng gặp lỗi trước đó lẫn trường hợp thông thường. Khi sự cố đã ổn định, hãy viết một timeline ngắn giải thích tác nhân kích hoạt, lỗ hổng trong khâu phát hiện, các điều kiện góp phần gây ra sự cố, thay đổi khắc phục và monitor hoặc bài kiểm thử sẽ giúp phát hiện vấn đề sớm hơn vào lần tới.
Bài viết liên quan
Đọc thêm
Thẻ :
- Phát triển web

